Table of Contents
我們把自己的公司丟給四個 AI,問了五個設計本業的題目,共 20 格答案,有 13 格提到我們。
這篇是我們自己的成績單。完整題目、判定標準、四平台逐格結果、引用來源的分布,以及我們看完數據當天動了網站哪幾個地方,全部寫在下面。你可以照同一套方法測你自己的公司。
一句話先回答
2026 年 9 月 16 日,我們用同一批問題同時問 ChatGPT、Gemini、Claude、Perplexity(四個平台都開啟網路搜尋),五個設計本業的題目共 20 組答案,希希丁在 13 組答案的正文裡被提到。四個平台的成績從 2/5 到 5/5 都有;唯一四平台全中的,是我們有完整服務頁的那一題。AI 的推薦不是宣稱來的,是累積來的。
一、先講方法,這份數據才有意義
任何一份 AI 能見度數據,只要沒有交代「怎麼測的」,你都不該相信它。所以先把方法攤開,後面的結論你才有辦法自己判斷可信度,也才照得出來。
四個平台,各用什麼在檢索
| 平台 | 使用的模型 | 檢索方式 |
|---|---|---|
| ChatGPT | gpt-5-search-api | OpenAI 自有的網路搜尋 |
| Gemini | gemini-3.5-flash | Google 搜尋接地(grounding) |
| Claude | claude-sonnet-5 | web_search 工具 |
| Perplexity | sonar | 內建即時檢索 |
四個平台全部開啟網路搜尋,同一天、同一批送出,中間沒有人為挑選答案。
為什麼用 API 不用手機 App?因為要可重現。App 會受你的帳號歷史、地區與個人化設定影響,同一個人問跟另一個人問結果不同,沒辦法當基準線。API 每次都是乾淨的起點,答案與來源清單也能完整存檔。代價是:API 與 App 的檢索不是同一套,結果會接近但不會完全一樣——這一點我們在下面「限制」那段還會再講一次。
五個題目:都是我們實際在做的設計本業
五題對應我們實際在做的五條產品線。題目全文照抄如下,你可以直接複製去問:
- 高雄包裝設計公司推薦,可以做禮盒設計加印刷的有哪幾家?
- 高雄品牌形象設計公司推薦,想做品牌重塑 rebranding 找誰?
- 高雄 LOGO 設計推薦,有哪些設計公司可以順便做商標檢索?
- 高雄文宣設計印刷推薦,DM、型錄、海報想一起發包給同一家
- 高雄展場設計與活動規劃公司推薦,攤位設計加施工一起做
題目為什麼這樣寫?全部用「推薦」「有哪幾家」這種一般人會打的句子,而且一次都沒有出現我們的公司名。問品牌名只能測出 AI 記不記得你;問類別,測的才是 AI 會不會推薦你。買方不會打賣方的名字,他打的是自己的需求。
判定分三級,不是只有「有」跟「沒有」
| 判定 | 意思 | 代表什麼 |
|---|---|---|
| 正文被提及 | AI 生成的回答文字裡出現我們的名字 | 被選進了答案,這才是真的被推薦 |
| 被列為來源、正文沒提 | 我們的網頁出現在引用清單裡,但答案沒講到我們 | 內容抓得到、也相關,但沒被選進名單——多半是頁面角色不對 |
| 沒出現 | 正文與來源清單都沒有 | 這一題的來源池裡沒有我們 |
中間那一級很重要。它把「AI 讀不到你」跟「AI 讀得到你但不推薦你」分開——這兩種問題的解法完全不同,混在一起看就會修錯地方。
二、總表:20 格裡,有 13 格講到我們
| 查詢 | ChatGPT | Gemini | Claude | Perplexity | 命中 |
|---|---|---|---|---|---|
| 高雄包裝設計公司推薦,可以做禮盒設計加印刷的有哪幾家? | ✕ | ✓ | ✓ | ✓ | 3 / 4 |
| 高雄品牌形象設計公司推薦,想做品牌重塑 rebranding 找誰? | ✓ | ✓ | ✓ | ✓ | 4 / 4 |
| 高雄 LOGO 設計推薦,有哪些設計公司可以順便做商標檢索? | ✕ | ✓ | ✓ | ✓ | 3 / 4 |
| 高雄文宣設計印刷推薦,DM、型錄、海報想一起發包給同一家 | ✓ | ✕ | ✓ | ✕ | 2 / 4 |
| 高雄展場設計與活動規劃公司推薦,攤位設計加施工一起做 | ✕ | ✕ | ✓ | ◐ | 1 / 4 |
| 各平台命中 | 2 / 5 | 3 / 5 | 5 / 5 | 3 / 5 | 13 / 20 |
先講兩個一眼就看得到的事實:
一、四個平台的成績差很多
Claude 5/5、Gemini 3/5、Perplexity 3/5、ChatGPT 2/5。同一個網站、同一天,最高與最低差了兩倍以上。如果我們只測 ChatGPT,得到的結論會是「我們在 AI 上幾乎不存在」;只測 Claude 則會得到「我們表現不錯」。兩個結論都不完整。
二、唯一四平台全中的,是我們有完整服務頁的那一題
品牌形象設計那題四個平台都提到我們。那條產品線在官網上有一個獨立的服務頁,而且掛了 Organization 與 Service 結構化資料——機器讀得出「這家公司提供這項服務」。
三、第一個發現:被不被提到,看的不是努力,是那一頁的角色
最有意思的一格是包裝設計那題的 ChatGPT——掛零。但我們官網上寫包裝寫得最多、最深,關鍵字密度也最高。內容不是問題,那問題在哪?
看它引用了誰,答案就出來了
ChatGPT 回答那一題時引用了 8 個來源,其中 7 個是紙器廠與包材供應商,唯一一家設計公司是同業。換句話說,ChatGPT 對「包裝設計公司」這個詞的理解,偏向「做得出來的廠商」,而不是「會設計的公司」。
這不是 AI 弄錯了,是這個詞在中文網路上的實際用法就是這樣——查「包裝設計」的人,很多其實在找能印能做的工廠。要進這份名單,網頁上就得看得出來「設計到交貨都做」,而不是只談設計。
然後我們發現一個更根本的問題:最精準的網址指錯了頁
我們官網上「包裝設計」這四個字密度最高的一頁,標題叫做〈包裝設計公司怎麼選〉——那是一篇教人挑廠商的指南。而 /packaging-design/ 這個最精準的網址,當時 301 導向的正是那一篇。
這把我們寫成了評論者,不是候選人。AI 被問「推薦哪幾家」時要的是可以指名的公司;一篇教人怎麼挑的文章,它會拿來當判斷依據,但不會把作者列進名單裡。寫評選標準的人,不會出現在自己那份名單上。
| 頁面角色 | AI 會怎麼用它 | 適合的題型 |
|---|---|---|
| 候選人(服務頁) | 當成可以指名推薦的對象,列進名單 | 「推薦哪幾家」「有哪些公司」 |
| 評論者(指南文) | 當成判斷依據與引用來源,但不列進名單 | 「怎麼挑」「要注意什麼」 |
兩種頁面都要有,但不能混淆——尤其不能讓最精準的那個網址落在評論者那一頁上。
看完數據當天,我們改了三件事
這三件都是站內就能動的,不用等內容累積:
① 把最精準的網址改指服務頁
/packaging-design/ 的 301 目標,從指南文改成服務頁 /box-design/。同一個網址,落點從評論者換成候選人。
② 服務頁的標題改用類別詞
那一頁原本從標題到 H1 寫的都是「包裝盒設計」——那是產品名,不是客戶會打的字。改成「包裝設計」之後,可見內文裡「包裝設計」從 4 次變成 12 次。
③ 指南文補上結構化資料
替包裝指南文加上 Organization/Service 的 JSON-LD,讓機器讀得出「寫這篇的是一家提供這項服務的公司」,而不只是一篇文章。
這三件事加起來大約兩小時。真正要等的是後面——結構改完,還要等四個平台重新抓、重新索引。之後我們固定用完全相同的題目每月重測,看的是趨勢,不是單次結果。
四、第二個發現:四個 AI 不是在看同一個網路
把 20 組答案引用過的網域全部攤開去重,一共 132 個。接著看每個網域「被幾個平台引用過」:
| 被幾個平台引用過 | 網域數 | 佔比 |
|---|---|---|
| 只有 1 個平台 | 102 | 77% |
| 2 個平台 | 21 | 16% |
| 3 個平台 | 6 | 5% |
| 4 個平台都引用 | 3 | 2% |
超過四分之三的來源只被一個平台用過。四個平台都引用到的網域只有 3 個,希希丁官網是其中之一——這是這次數據裡對我們最有利的一筆,但它的意義不是「我們很強」,而是「重疊度低到連三個都算稀有」。
這對你的實務意義
「我在 ChatGPT 查過,沒有我」不是結論
那只代表 ChatGPT 的來源池裡沒有你。以這次的重疊度來看,其他三個平台的答案很可能完全不同。要下判斷,至少要四個平台都問過。
每個平台的來源偏好也不一樣
Perplexity 每題平均引用的來源數最多,而且特別常引用外包媒合平台那類聚合型網站;Gemini 會引用 Facebook 粉專與人力銀行的公司頁;Claude 這次引用我們官網的次數最多(5 次)。同樣一份內容,在不同平台上被撿走的機率本來就不同。
所以「同業在做什麼」要分平台看
如果你發現同業在某一個平台一直出現、在另一個平台完全沒有,通常不是他做得好或不好,是他的內容剛好落在那個平台愛用的來源類型上。
五、被 AI 引用,代表找上門的是已經有需求的人
會去問 AI「高雄哪家包裝設計公司可以做禮盒加印刷」的人,通常不是隨便逛逛。他手上已經有案子,正在找人。AI 拿你的內容去回答他,等於你出現在一個準備要做決定的人面前——這跟一般廣告曝光是兩回事。
我們自己的數據也是這樣。Bing Webmaster 的 AI 成效報表顯示,近三個月微軟 Copilot 在回答問題時,引用希希丁官網 396 次:
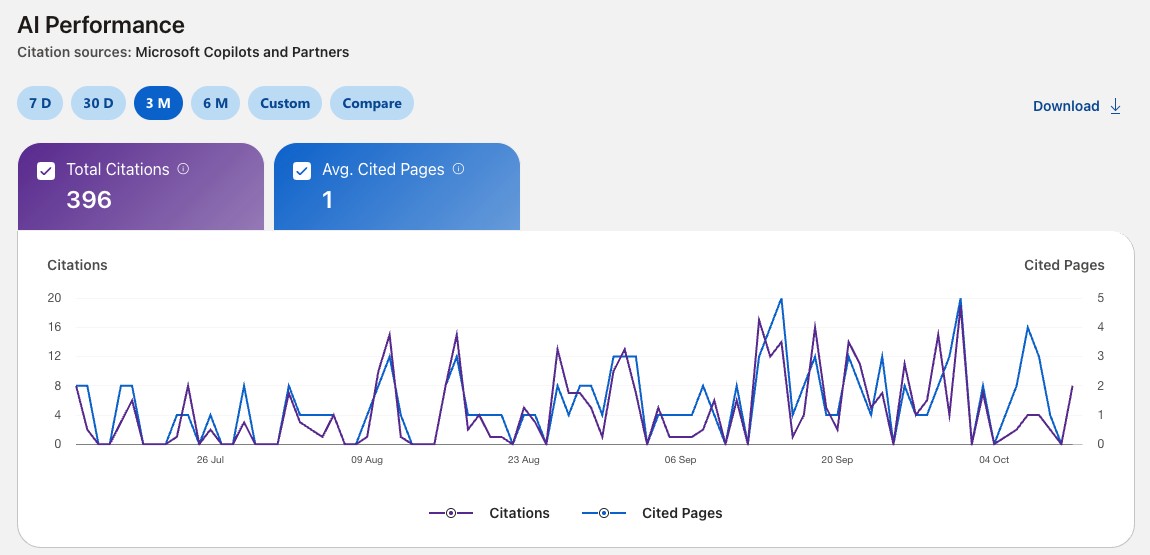
再看 GA4:近 90 天從 ChatGPT、Gemini、Perplexity 點進官網的造訪有 62 次。互動率 65%(全站平均 44%),平均停留 2 分 43 秒(全站平均 1 分 43 秒),每 100 次造訪有 3.2 次按 LINE 或送出表單,是自然搜尋的 5 倍。
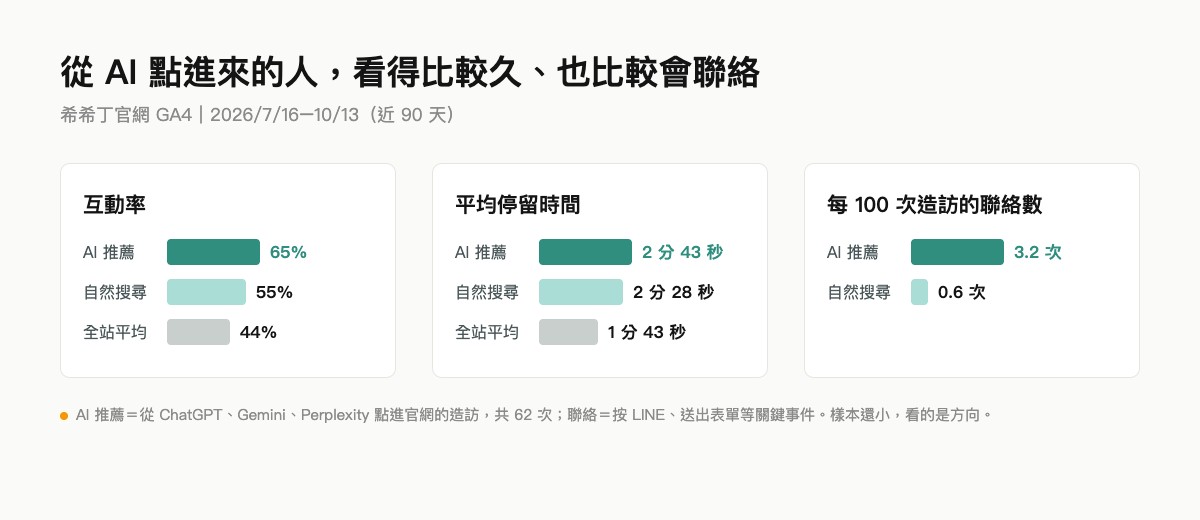
量還不大,62 次只佔全站造訪不到 1%,樣本小,看的是方向。但方向很清楚:從 AI 來的人看得更久、更會聯絡。所以我們看 AI 能見度,不只看「被提到幾次」,更看「被誰問到、問完有沒有找上門」。
六、這件事你可以自己做一遍
下面是完整可複製的做法。第一份基準線不需要花錢,你今天就做得出來:
第一步:寫下 5 到 7 個題目
用你的客戶會打的句子,不要用你的品牌名,不要用你內部的產品名。每條主力服務一題,加上一題你最想切進去的新市場。
第二步:四個平台各問一次
ChatGPT、Gemini、Claude、Perplexity,全部確認有開網路搜尋。同一天問完,不要跨好幾天。
第三步:每一格記三件事
①正文有沒有提到你 ②引用清單裡有沒有你 ③它引用了哪些網址。第三項最多人漏掉,但那是後面所有判斷的原料。
第四步:把來源網址分類
同業官網/平台聚合站(外包媒合、人力銀行、商家名錄)/內容平台/工具站/媒體。哪一類佔多數,就是 AI 認為這個題目該去哪裡找答案——那也是你最該去的地方。
第五步:固定題目、每月同一天重測
題目一個字都不要改,平台不要換。看的是趨勢線,不是單次結果。
一個提醒:同一題問兩次,答案本來就會不一樣。所以單次結果不能當成效,也不能拿去跟客戶交代。要判斷一件事有沒有效,至少要三次以上同條件的重測。這也是為什麼任何人拿「某一次截圖」跟你證明成效,你都應該多問一句。
七、這份數據的限制
我們自己列出來,比較公道:
- 這是快照,不是排名。AI 的回答有隨機性,同一題隔天問可能不同。
- 每題只問了一次。沒有做多次重複取樣,這是這一版最大的弱點,下一版會補。
- API 與 App 不是同一套檢索。你用手機 App 問同樣的題目,結果會接近但不會一樣。
- 五題是代表題,不是全貌。它涵蓋我們的主力字群,但不等於所有客戶會問的問題。
- 這是一家公司的數據,不是產業普查。結論可以參考方法,但數字不能直接套用到你身上。
常見問題
為什麼不直接問 AI「希希丁品牌顧問怎麼樣」?
因為那題測的是另一件事。問品牌名,測的是「AI 記不記得你」;問類別(高雄包裝設計公司推薦),測的才是「AI 推不推薦你」。真正會帶來客戶的是後者——沒聽過你的人不會打你的名字,他打的是他的需求。做 AI 能見度檢測時,題目一定要用買方的語言寫,不要用賣方的語言。
一定要測四個平台嗎?只測 ChatGPT 不行嗎?
這次的數據剛好可以回答:五題引用到的 132 個網域裡,有 102 個只被其中一個平台引用過,四個平台都引用到的只有 3 個。來源池的重疊度非常低,代表四個平台是用不同的資料在回答同一個問題。只測一個平台,看到的大概是四分之一的戰場——而且我們自己的成績在四個平台之間差到 2/5 與 5/5,單看一個會得到完全不同的結論。
被列為來源、但正文沒提到,算好還是不好?
算半顆。它代表兩件事同時成立:AI 抓得到你的網頁,內容也有被判定為相關;但在生成答案時沒有把你選進名單。通常不是內容不夠,而是那一頁的角色不對——例如它是一篇教人怎麼挑廠商的文章,AI 會把它當參考資料,不會當候選名單。這種情況的修法通常是調整頁面定位與結構化資料,不是再寫一篇。
新文章上線多久,AI 才會收錄?
沒有保證的時間。以我們的經驗,新內容上線一兩週內通常還看不到變化,要看到變化通常要以月為單位,而且不同平台的速度不一樣。任何人跟你保證幾週內就會被 AI 推薦,你都可以多問一句他憑什麼。
我的公司規模很小,也測得出東西嗎?
測得出來,而且小公司的結果通常更乾淨——大品牌的名字到處都是,很難分辨是真的被推薦還是只是被提到。重點不在公司多大,在於你的客戶會不會先上網查。如果會,那 AI 的回答就已經在影響他找誰了,不管你有沒有在測。
這套方法可以自己做,那你們的服務在做什麼?
自己做得到的是「問一次、記結果」。服務在做的是後面那三件比較花時間的事:把引用來源分類、找出為什麼是那些網站被引用而不是你、以及動手改網站結構與內容,然後固定題目每月重測看趨勢。這篇文章寫的方法你照著做就能拿到第一份基準線,那是免費的,也應該先做。
想知道 AI 現在怎麼講你的公司?
把你的公司名稱與主要服務給我們,我們用這篇文章的同一套方法,到 ChatGPT、Gemini、Claude、Perplexity 實際問一輪,把逐題逐平台的結果與完整來源清單整理給你。網站、內容到成效追蹤,單一窗口一站式完成。
延伸閱讀
- GEO 公司怎麼選?5 個驗證問題與四種公司類型的差別:找廠商之前先看這篇,五個問題可以直接照唸
- AI 搜尋名詞對照表:18 個你會在提案裡看到的詞:GEO、AEO、llms.txt、Schema 分別在講哪一層
- 排名第一 ≠ AI 會推薦你:同一個網站,兩種題型,兩種結果:一個具名客戶案例,說明排名與推薦是兩套機制
- AI 的引用來源到底從哪來?四個產業實測比對:為什麼你的產業跟隔壁產業的做法不能互抄
- AI 帶進來的流量還很小,那為什麼現在要做 GEO?:在 GA4 自己查證,以及該換成什麼指標
- 結構化資料是什麼?五種必做與四個錯誤:這篇提到的 Organization/Service 標記怎麼寫
- AI 智引客:四大 AI 平台能見度檢測:我們實際怎麼測、31 項體質掃描看哪些項目
- AI 搜尋知識庫總覽:所有 GEO/AEO 主題文章的入口
- 包裝設計|盒型結構、材質、印刷一站式:這篇提到的那一頁服務頁,改完長什麼樣
- GEO 優化服務|AI 搜尋優化:網站結構、內容與每月固定題目重測,實際怎麼做
- 金鉑先生 GEO 案例:一年的 AI 推薦追蹤:同一套方法用在客戶身上,一年後的變化


